
“你这篇论文的问题设定是什么?”
“这个符号在公式里代表什么物理/数学含义?”
“摘要里说‘模型精度提升12.3%’,这数字在哪张表、哪段实验分析里出来的?”
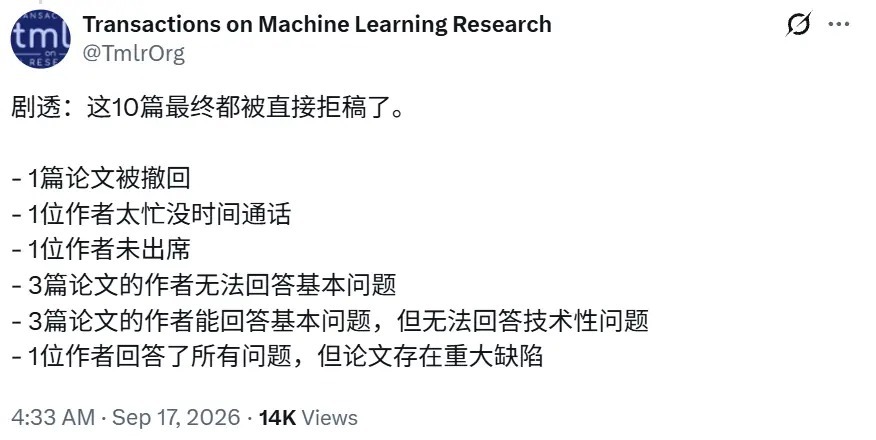
不是答辩现场,也不是博士中期考核——这只是TMLR期刊一位主编发来的10分钟语音面试邀约。结果?10篇待拒稿,全被毙了。7位到场作者里,3人连基础问题都答不上来;另3人能讲个大概,一问“为什么选这个损失函数”“训练时batch size设为64的依据是什么”,立马卡壳;剩下1位全答对了,但主编边听边翻原文,发现核心结论根本站不住脚——作者当场承认推导有误。
这事没藏着掖着。CMU教授Nihar B. Shah把过程写进官方博客,标题就叫《向作者询问他们自己的论文》。他没用AI检测工具,没查重复率,就靠三五个直球问题。因为真动手做过实验、推过公式、改过十遍代码的人,根本不用背答案——那些细节早刻进肌肉记忆里了。而AI生成的文本再流畅,也填不满“为什么”和“在哪里”的坑。
更扎心的是,被揪出来的不全是学生。有高校讲师,有独立研究者,甚至还有带团队的青年PI。身份五花八门,漏洞却高度一致:能复述结论,讲不清逻辑;记得图表编号,说不清数据怎么来的;摘要写得像新闻通稿,正文却找不到支撑句。这不是粗心,是压根没读过自己提交的PDF。
学术圈没急着上技术防火墙,反而开始回归最笨的办法:聊一聊。不是审稿,是确认“这个人是否真的参与了这项工作”。这波操作背后没玄学,只有常识——知识一旦没经过大脑重装,再漂亮的文字也只是租来的衣服,一问尺码,立刻露馅。
这种“真人快打”式审核,最近在TMLR、JMLR、NeurIPS等顶会期刊悄悄铺开。不是全员突击,但主编们开始把“语音/视频确认”写进初审流程备注栏。MIT一位编委透露,他们团队试了三个月,拒稿率没变,但“作者撤稿率”从8%飙升到23%——很多人一听要语音连线,直接点取消提交。不是怕问题难,是怕连自己论文第几页写了什么都说不准。
有意思的是,被拦下的不少是“高产户”。有位三年发17篇AI方向论文的讲师,6篇被要求语音核验,全卡在同一个地方:问“你用的开源数据集版本号是多少”,答“应该是最新版”;再问“训练时是否用了mixup增强”,答“好像用了……记不清了”。后来查原始代码仓库发现,他提交的.zip包里根本没包含训练脚本,只有整理好的结果表格和LaTeX源文件——整篇论文像一份PPT讲稿,没有施工日志,只有竣工效果图。
这事儿也倒逼出新动作。ACL 2024首次要求所有录用论文附带“可复现性声明表”,必须手填:模型参数在哪行代码初始化、随机种子设了几、GPU型号与驱动版本、甚至PyTorch具体小版本号(比如2.1.2而非笼统写“2.x”)。不是刁难,是补上过去十年漏掉的一课:科研不是拼图游戏,每一块都得知道它从哪来、怎么咬合。
当然,也有人真刀真枪扛住了。一位北大博士生被问到“图4中那个反常的loss下降拐点,是不是因为你在第127轮手动降低了学习率”,他当场打开共享屏幕,调出tensorboard日志截图,指出那其实是早停触发前的最后一次验证集评估波动。主编听完笑了:“你这不像答辩,像修车师傅听发动机异响。”
说到底,学术不是秀场。你写的每一个字,都该经得起别人指着屏幕问:“这里,为什么?”——不是考你记忆力,是看你有没有亲手拧过那颗螺丝。毕竟,真正的研究者不靠文字活着,靠问题活着。问题在,人就在;问题一问三不知,再厚的PDF,也只是纸糊的壳。
天顺优配提示:文章来自网络,不代表本站观点。