
你试过用机器人把一本书轻轻推进书架吗?看起来就三步:找空位、对准、往前推。可真到书脊碰到旁边那本时,麻烦来了——是卡住了?还是歪了?推够深没?这时候摄像头拍得再清楚也没用,画面几乎纹丝不动,全靠‘手上的劲儿’来判断。以前这事儿AI干不了,不是不想学,是根本没机会学:力觉数据得接真实机械臂、装六维力传感器、一条条手动标定……成本高、周期长、还难泛化。业内常开玩笑说:‘想让机器人有手感,先得烧掉一辆Model 3的钱买数据。’
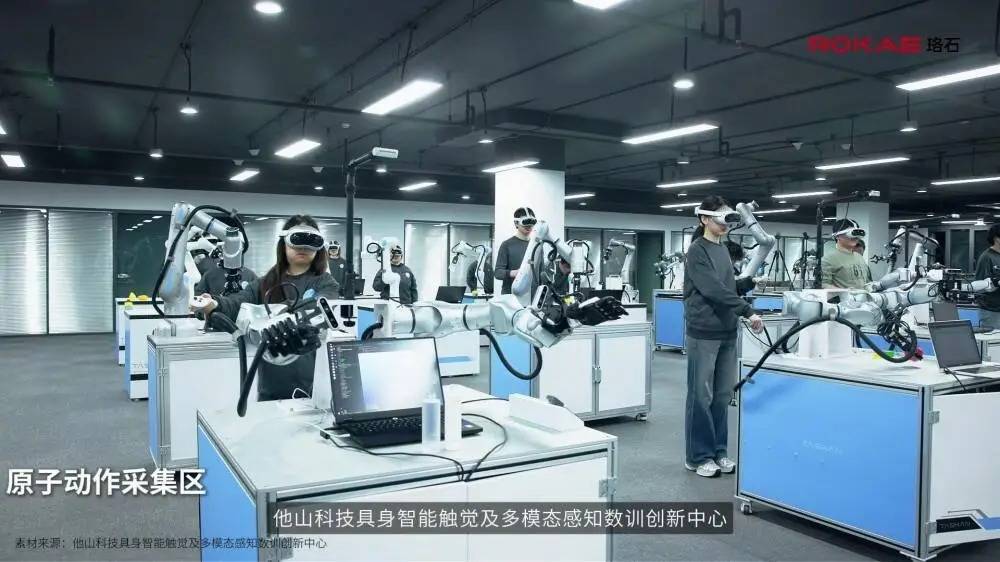
上海交大卢策吾、汶川团队联合穹彻科技,偏不走这条路。他们没重训大模型,没改原始架构,甚至没用上万条力数据——实测只用了20~30条真实接触时的力信号,就让一个已预训练好的VLA(视觉-语言-动作)模型当场‘觉醒触觉’。方法叫LIFT,中文名很直白:力觉醒。它像给老司机加装一套实时反馈的‘电子后视镜’,不换车、不重考驾照,只在行驶中微调反应节奏:一感知到异常阻力,立刻缩力、微调角度、再试探——整个过程毫秒级响应,完全不用等下一帧视觉输入。
更妙的是,它没让模型‘忘本’。叠毛巾时能识别布料褶皱+实时感知张力变化;插书时既看封面朝向,又靠指尖反推确认入位深度;连汉诺塔圆环放置这种需要‘轻拿轻放+中途纠错’的任务,成功率也比纯视觉方案高出40%以上。这不是炫技,是把‘摸’这件事真正塞进了AI的决策闭环里。CoRL 2026高分收录不是偶然——它第一次跑通了‘先学看和说,再练摸和做’这条新路子。以后哪怕换新硬件、加新传感器,也不用从头炼丹了。
这事儿听着玄乎,其实逻辑特别朴素:人学技能哪有全靠眼睛的?小时候搭积木,手指一碰就知歪不歪;包饺子时捏边,力道轻了漏馅、重了破皮——全是触觉在悄悄校准动作。AI过去卡在“看不见的力”上,不是算力不够,是训练范式拧巴了:非得把触觉塞进模型肚子里当主食,结果数据没喂够,模型先消化不良。
LIFT反其道而行之,把力信号当“提神醒脑的咖啡”,只在关键接触瞬间泼一勺进去。论文里那20多条数据,每一条都来自真实书本入架、毛巾折叠、圆环落位时最“硌手”的那一刹那——比如书脊刚蹭到邻书侧边的0.3秒,或毛巾第三层被拉扯时张力突增的峰值。这些片段短得像眨眼,却精准锚定了“力-动作-结果”的因果链。团队没藏着掖着,开源代码里连传感器型号、采样频率、滤波参数都标得明明白白,高校实验室接上普通UR5机械臂就能复现。
有人担心:这么少的数据,靠不靠谱?实测说话——在交大机器人实验室,同一台机器连续三天插300本书,错位率从纯视觉方案的18%压到不足4%;更较真的是他们让机器人徒手捏豆腐块:不许碎、不许滑、还得稳稳放进小盒。纯视觉模型试了7次全塌,LIFT调了3次参数就成功——不是靠蛮力,是感知到指尖豆腐表面微形变后,自动把抓握力从3.2N降到2.6N。
这不是要取代人类手感,而是给机器补上那块拼图。养老院里帮老人整理药盒,力控差一点就打翻铝箔;产线上装配精密轴承,过盈配合容不得0.01毫米误差。技术落地从不靠PPT里的“完美曲线”,而是一次次在真实书脊、真实布料、真实豆腐上磨出来的分寸感。毕竟,真正的智能,从来不在云端,而在指尖与世界相触的那一毫秒。
天顺优配提示:文章来自网络,不代表本站观点。