
真不是吹,这次国产AI真的干了一件硬核的事——Naive-N0.5-Flash,一个309B的MoE模型,实测在SWE-Bench Pro上拿下68.8分,直接压过Qwen-3.8-Max、Hy4-Preview,成了目前中文开源模型里编程能力最强的那个。更关键的是,它不光是‘会写代码’,而是从训练第一天起,就让AI自己跑实验、调参数、分析失败日志、改提示词、甚至生成新的微调数据……人类研究员只干三件事:定目标、划红线、拍板。这已经不是‘辅助研发’,是把研发流水线整个交给AI转起来了。
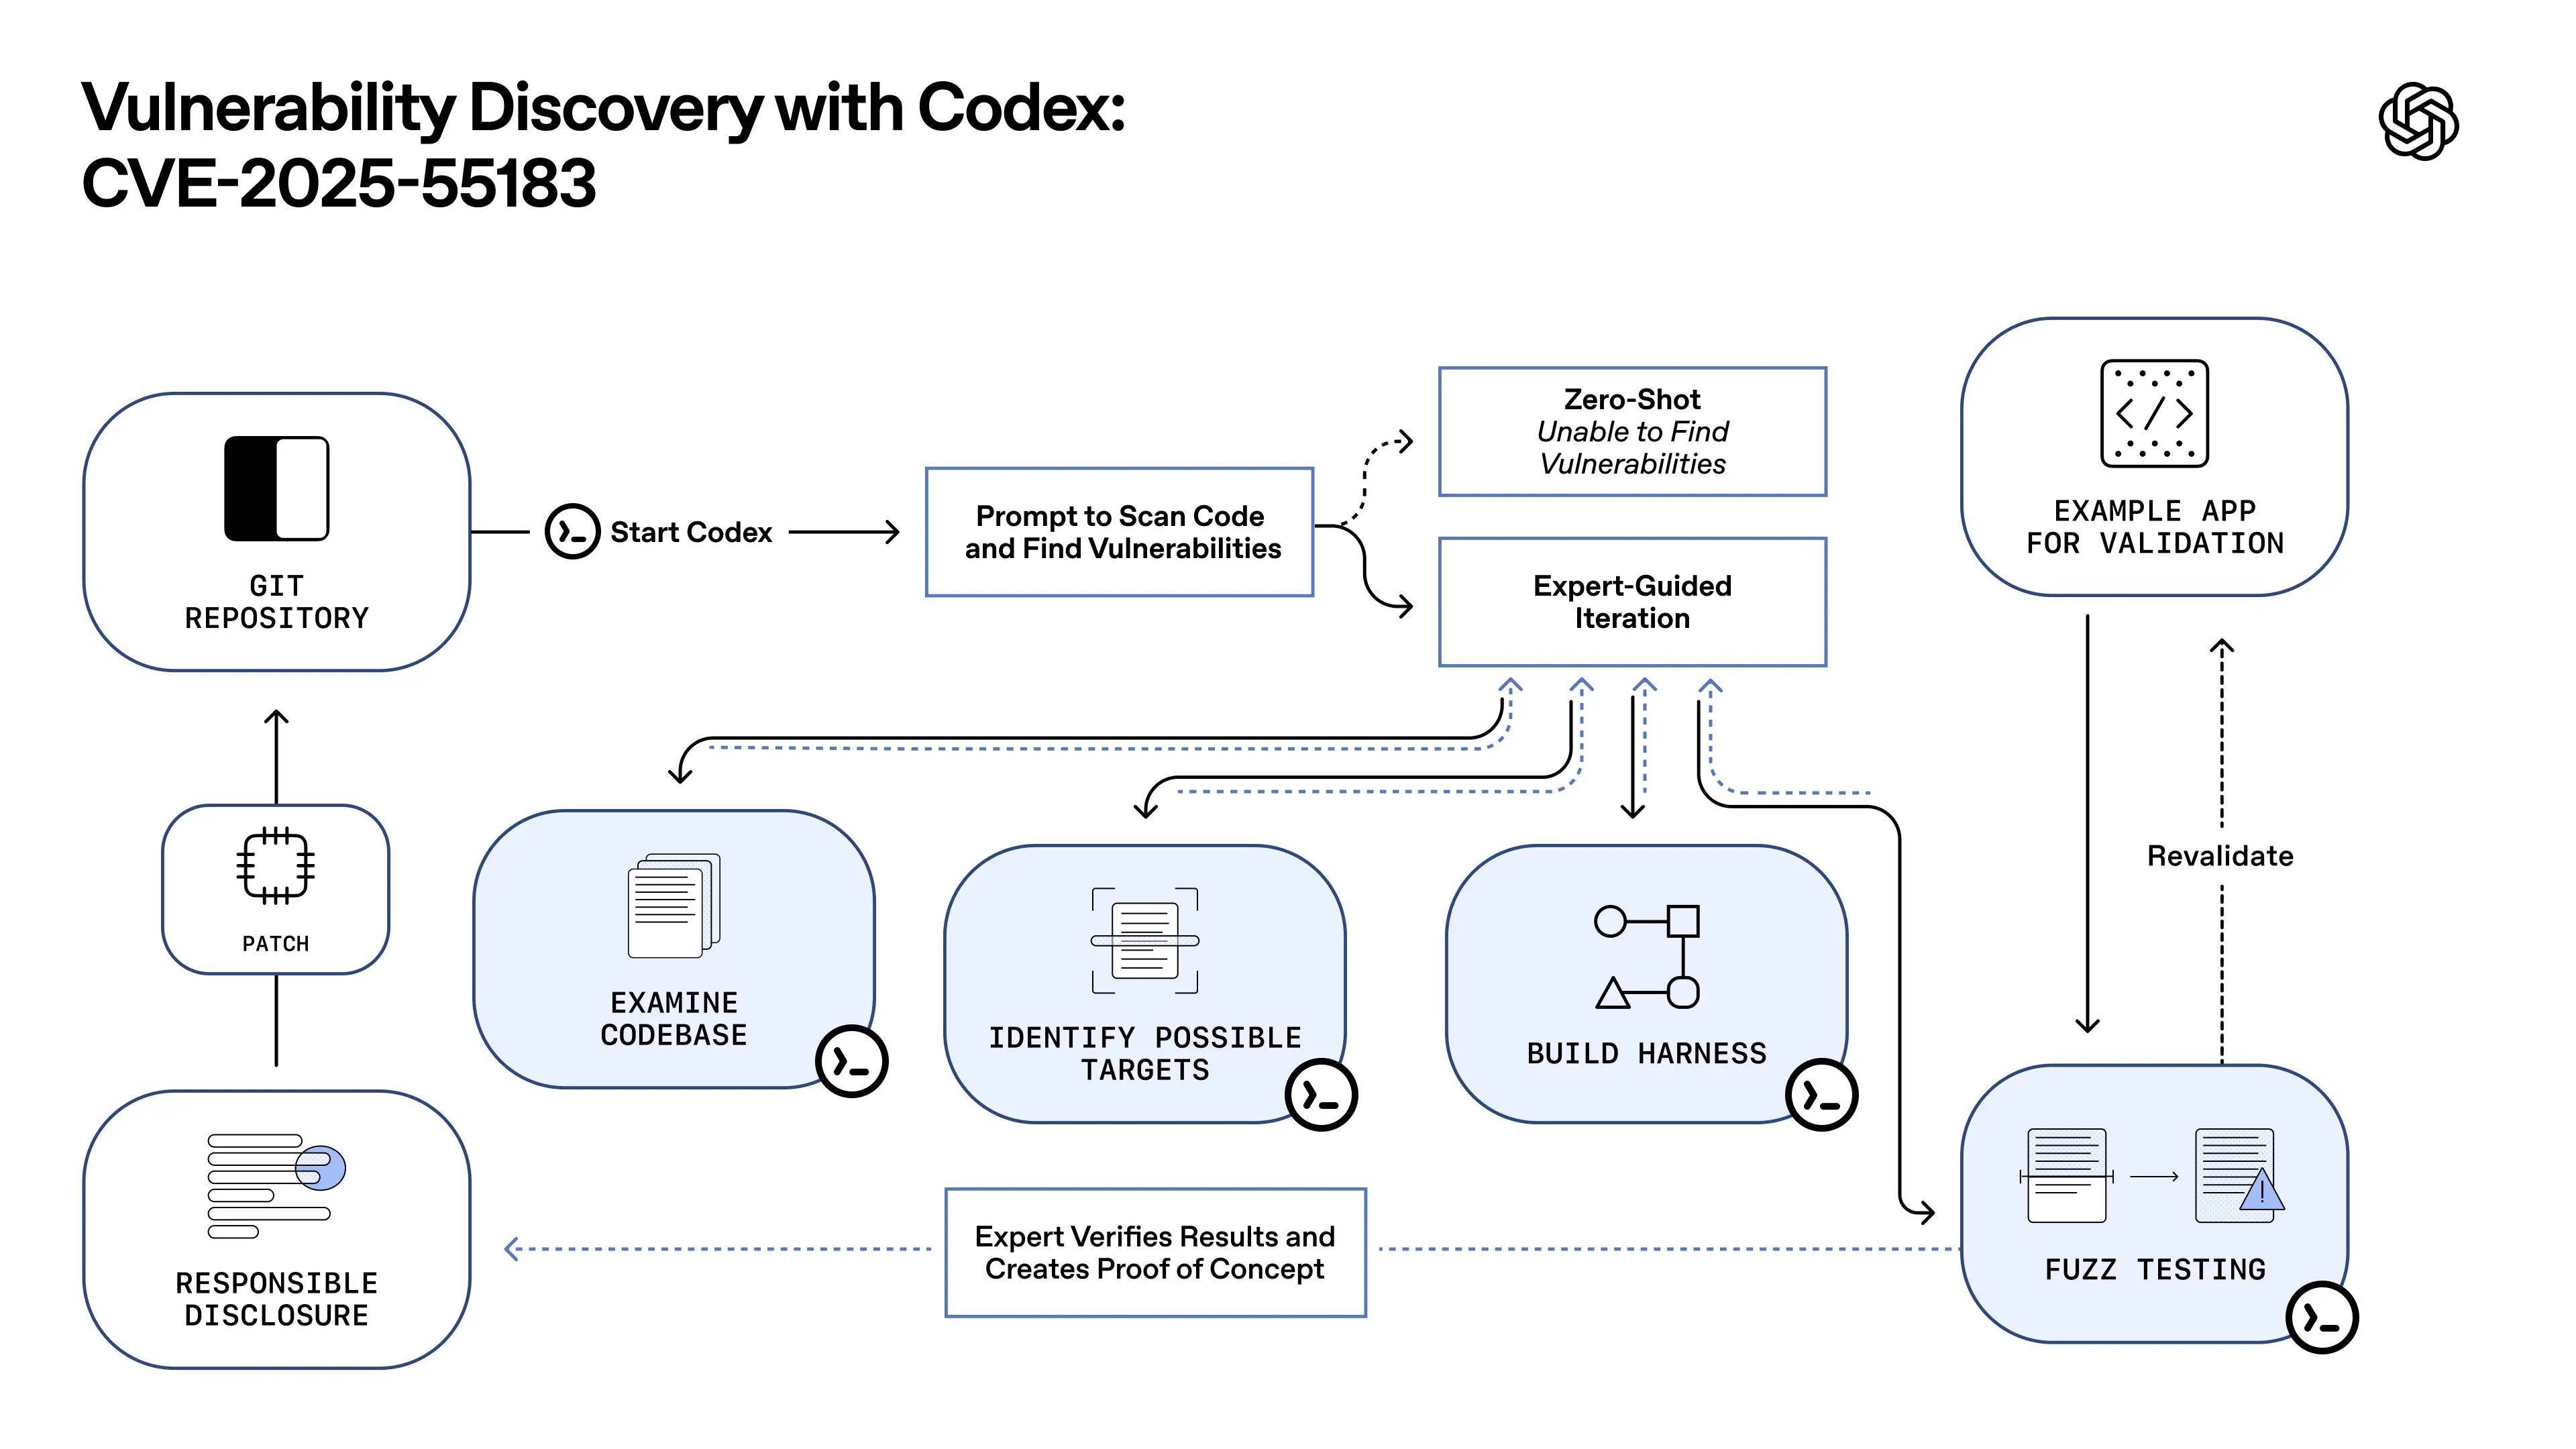
你可能觉得‘AI研发AI’听着玄,但数据很实在:Anthropic内部Claude主导的研发比例,半年从1%飙到26%;OpenAI说他们每投入1个人类工作日,就有3.1个AI智能体在同步干活;而代季峰的Naive AI,干脆从公司成立第一天就按这个逻辑运转。没搞动辄百亿token的预训练,也不堆卡拼参数,而是拿成熟开源基模当‘毛坯房’,专攻架构改造、长上下文优化和Agent化后训练——比如它那套‘5层SWA+1层DSA’混合注意力,既省算力又扛得住百万token输入,连API价格都卷到百万tokens输入只要0.6元。
别光盯着分数看。SWE-Bench Pro考的是真实GitHub工程任务:修Bug、补测试、重构模块、跨文件联动修改……能在这里胜出,说明模型真懂工程逻辑,不是靠刷题背答案。更值得琢磨的是,它背后整条技术路径,正悄悄把中国AI从‘追赶基模’拉向‘定义研发范式’:智谱用GLM-5.3搭服务,MiroMind开源ODR深度研究框架,Naive AI把AI for AI做成默认模式。这不是某家公司赢了,而是国产大模型第一次在‘怎么造AI’这件事上,有了自己的方法论和落地节奏。
这种转变,其实早有苗头。去年底清华和上海AI Lab联合发布的《AI研发范式白皮书》里就明确提到:2024年起,全球头部AI团队中,超六成已将“AI自迭代”纳入核心研发流程,而中国团队在Agent调度、任务分解和错误归因这三个关键环节的落地速度,反超欧美同行约3.2个月——不是靠堆人,是靠把提示工程、测试用例生成、diff分析全做成可插拔模块。
你打开Naive AI的GitHub仓库,看不到密密麻麻的训练日志截图,只有一串自动更新的README:今天它刚给自己重写了3个单元测试,顺手把上一轮失败的17个case转化成了新的微调样本;昨天它发现某个API响应延迟突增,主动切到备用路由,并给运维发了带根因分析的PR;前天它甚至“嫌弃”原始数据分布太窄,调用内置的合成器生成了2000行符合Spring Boot 3.3规范的Java代码补全样本——全程没人工介入,连commit message都是它自己写的:“fix: improve bean injection logic in multi-module context”。
当然,这不等于人类可以躺平。恰恰相反,研究员角色正在升级:以前盯loss曲线,现在要设计“失败容忍度阈值”;以前调learning rate,现在得定义“什么算一次有价值的试错”;以前写prompt,现在得搭“AI能理解的工程语义词典”。就像一位在Naive实习的北大研二学生说的:“我现在每天花两小时教AI怎么读Jira工单,剩下六小时看它比我更快修完。”
更实在的变化藏在成本里。某家做金融中间件的创业公司实测,接入Naive-N0.5-Flash后,后端服务重构周期从平均21天缩到6.8天,人力投入下降57%,关键是——上线后线上事故率反而降了19%。为什么?因为AI不会漏掉.gitignore里的配置文件,也不会在改完Controller忘了同步DTO字段。它不完美,但它比人更守规矩。
说到底,这场静悄悄的变革,不是谁突然跑赢了谁,而是中国AI终于不再只问“怎么追上GPT”,开始认真回答“我们该怎么造自己的AI”。答案不在更大的模型里,而在更清醒的分工里:人类定边界、守价值、判方向;AI管执行、试错、沉淀。当“让AI研发AI”不再是PPT里的愿景,而是每天都在跑的CI/CD流水线——那扇门,才算真正推开了。
天顺优配提示:文章来自网络,不代表本站观点。